

 Nederlands
 English
 Español
 Français
 Deutsch
 Italiano
 Português
 日本語
 Русский
 한국어
 简体中文
 繁體中文
 العربية
 Български
 Català
 Ελληνικά
 हिन्दी
 Bahasa Indonesia
 Bahasa Melayu
 Polski
 Svenska
 ไทย
 Türkçe
 Українська
 Tiếng Việt
 Kiswahili
OCR (tekstherkenning)
Herken tekst in gescande pdf's en zet die om naar een doorzoekbare pdf, Word of platte tekst. Je bestanden worden in je browser verwerkt en nooit naar een server geüpload.
OCR (tekstherkenning)Geavanceerde downloads gebruiken de getoonde daglimiet voor bestanden. Gasten en gratis accounts kunnen verschillende limieten hebben. Pro heft de dagelijkse bestandslimiet op en wordt maandelijks of jaarlijks verlengd. Abonnementen en prijzen.
Gebruiksaanwijzing
Kies de documenttaal, herken de tekst, kies het uitvoerformaat en download.
Ook tekst in afbeeldingen herkennen
Combineert de PDF selecteerbare koppen met tekst in afbeeldingen, schakel dan vóór OCR ‘Ook tekst in afbeeldingen herkennen’ in. Sla daarna een doorzoekbare PDF op of ga verder naar Word. Selecteerbare tekst blijft behouden en overlappende OCR-woorden worden weggelaten om duplicaten te voorkomen. Controleer het resultaat vóór gebruik.
Alle tools
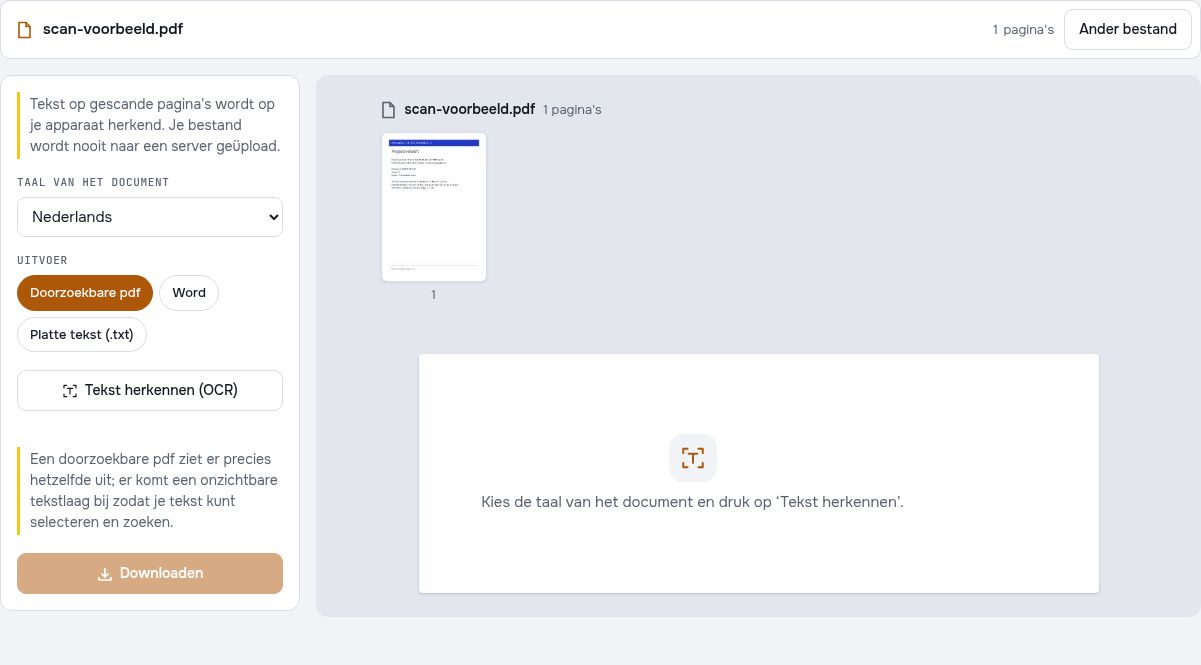
Een Nederlandse pagina zonder tekstlaag met OCR controleren
De scan-PDF bevat alleen een afbeelding van de eerste rapportpagina. De woorden zijn aanvankelijk niet selecteerbaar. Kies Nederlands als herkenningstaal en een beschikbaar uitvoerformaat. De afbeelding toont de voorbereiding, geen voltooid OCR-resultaat.
De taal van de inhoud kiezen
De afgedrukte taal is belangrijk, niet de interfacetaal. Controleer richting en scherpte voordat je begint. Duidelijke letters en gelijkmatig licht helpen bij eigen documenten. OCR kan afgesneden of onscherpe tekens niet betrouwbaar aanvullen.
Codes en accenten nalezen
Vergelijk DEMO-NL-001 en woorden zoals coördinatie en ideeën met het beeld. Zoek bij een doorzoekbare PDF een heel woord en controleer de selectielocatie. Controleer voor Word of tekst ook de volgorde van de regels.
Controleer het resultaat
- Controleer dat de bron geen selecteerbare tekstlaag heeft.
- Kies Nederlands voor de afgedrukte inhoud.
- Vergelijk referentie, accenten en zoekfunctie met de afbeelding.
Probeer fictieve bestanden
De voorbeeldbestanden bevatten verzonnen gegevens. Bewaar de originelen en controleer je eigen geëxporteerde kopieën. Voor geavanceerde downloads gelden de huidige limieten en Pro-abonnementen.
Verder werken met deze tools:
Veelgestelde vragen
Worden mijn bestanden naar een server geüpload?
Nee. Alles gebeurt in je browser, op je eigen apparaat; je bestanden worden nooit naar een server gestuurd.
Wat kan ik gratis gebruiken?
Basistools zijn gratis zonder account. Geavanceerde downloads gebruiken de getoonde daglimiet voor bestanden. Gasten en gratis accounts kunnen verschillende limieten hebben. Pro heft de dagelijkse bestandslimiet op en wordt maandelijks of jaarlijks verlengd. Abonnementen en prijzen.
Pro
Automatische verlenging voor de gekozen periode. Toekomstige verlengingen altijd opzegbaar. Belastingen staan bij het afrekenen.
Kan ik mijn geld terugkrijgen?
Ja. Zie het terugbetalingsbeleid voor de voorwaarden en termijn; stuur je verzoek via het contactformulier.
Waarom heeft de OCR-test een aparte scan-PDF?
Het gewone rapport heeft al selecteerbare tekst. De scan bevat alleen een afbeelding en is bedoeld om herkenning te proberen. Kies Nederlands en vergelijk de uitvoer met de oorspronkelijke pagina; de kwaliteit hangt van het document af.