

 Français
 English
 Español
 Deutsch
 Italiano
 Português
 日本語
 Русский
 한국어
 简体中文
 繁體中文
 العربية
 Български
 Català
 Nederlands
 Ελληνικά
 हिन्दी
 Bahasa Indonesia
 Bahasa Melayu
 Polski
 Svenska
 ไทย
 Türkçe
 Українська
 Tiếng Việt
 Kiswahili
Tous les outils › Convertir
Reconnaître le texte d’un PDF numérisé avec l’OCR
L’OCR reconnaît les caractères présents dans les images des pages pour permettre la recherche, la copie ou la réutilisation des mots. Le traitement s’effectue dans le navigateur. Les sorties suivent les conditions d’export avancé disponibles.
Les téléchargements avancés utilisent le quota quotidien de fichiers indiqué dans l’outil. Les quotas des invités et des comptes gratuits peuvent différer. Pro supprime le quota quotidien de fichiers et se renouvelle chaque mois ou chaque année. Quotas actuels et offres Pro.
Reconnaître le texte du PDFDocuments traités sur votre appareil · directement dans le navigateurComment appliquer l’OCR à un PDF
- Ouvrez le PDF numérisé et choisissez la langue de son contenu. Elle peut être différente de celle de l’interface.
- Lancez la reconnaissance et laissez la page ouverte. Les modèles de langue peuvent être téléchargés lorsqu’ils sont nécessaires.
- Relisez l’aperçu, notamment les noms, dates, montants et numéros de référence.
- Choisissez PDF recherchable, DOCX ou TXT et téléchargez avec l’accès avancé disponible. Ouvrez le résultat pour le contrôler.
Reconnaître aussi le texte des images
Si le PDF mêle des titres sélectionnables et du texte dans des images, activez « Reconnaître aussi le texte des images » avant de lancer l’OCR. Enregistrez ensuite un PDF avec recherche ou passez à Word. Le texte sélectionnable est conservé et les mots OCR superposés sont écartés pour éviter les doublons. Vérifiez le résultat avant utilisation.
PDF recherchable, Word ou texte brut
Un PDF recherchable conserve l’aspect du scan et ajoute une couche de texte. Un lecteur compatible peut rechercher et sélectionner les mots reconnus. La page ne devient pas pour autant un document Word.
DOCX permet de poursuivre dans un traitement de texte et peut demander des corrections de texte et de mise en page. TXT conserve le texte sans la composition des pages. Choisissez selon votre prochaine tâche.
Langue du document et qualité du scan
Choisissez la langue des pages pour guider la reconnaissance. Changer la langue de l’interface ne traduit pas le PDF. Reconnaissance de caractères et traduction sont deux opérations distinctes.
Un scan net et droit donne généralement de meilleurs résultats qu’une photo floue ou de très petits caractères. Vérifiez les confusions entre O et 0 ou I et 1. Les manuscrits et les pages complexes peuvent être reconnus de façon incomplète.
Traitement local et limites pratiques
Le PDF est traité dans le navigateur. Des logiciels et modèles de reconnaissance peuvent être téléchargés pendant l’utilisation ; cela ne correspond pas à l’envoi du document vers un serveur d’OCR.
Les fichiers longs demandent plus de mémoire et de temps. Vous pouvez d’abord extraire un groupe de pages avec Séparer PDF. Les téléchargements OCR utilisent le quota quotidien de fichiers disponible ou Pro.
Essayer avec des documents de démonstration
Les exemples contiennent des données fictives, sans informations réelles de clients. Les documents sources en anglais sont signalés. Gardez l’original pour comparer : un exemple ne garantit pas le même comportement pour chaque PDF.
Reconnaître une page dont les mots ne sont pas encore sélectionnables
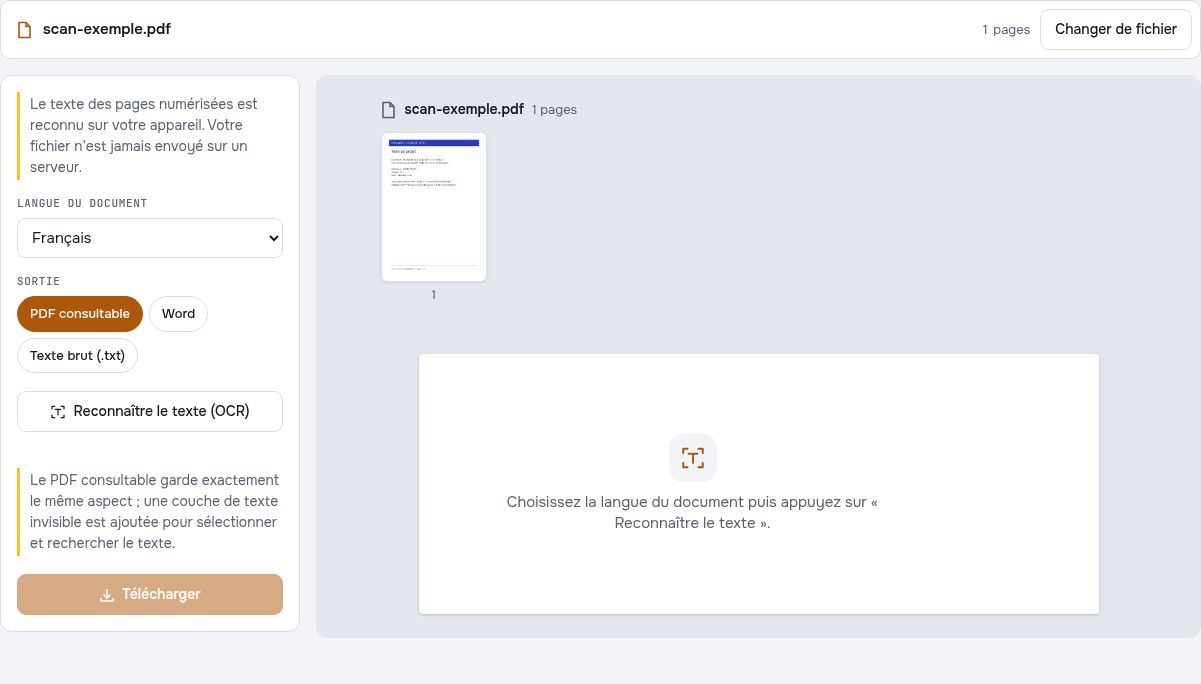
Le scan de démonstration contient une image de la note de projet, sans couche de texte. Essayez d’abord de sélectionner ses mots dans un lecteur. Après l’OCR, comparez le texte reconnu à l’image et au PDF de texte intact.
Choisir la langue imprimée dans le document
Sélectionnez le français pour cette page, même si vous utilisez l’interface dans une autre langue. La langue des menus n’identifie pas automatiquement les mots d’une image. Commencez avec cette seule page pour vérifier les ressources disponibles et la capacité de l’appareil.
Relire les accents et les références
Contrôlez DEMO-FR-001, Version : A et Utilisateur fictif. Portez attention aux caractères accentués et aux lettres proches de chiffres. Pouvoir retrouver un mot ne confirme pas que chaque caractère de la page ou son ordre de lecture a été correctement reconnu.
Vérifiez le résultat
- Confirmez l’absence de texte sélectionnable dans le scan initial.
- Choisissez le français comme langue de reconnaissance.
- Comparez les noms et les codes reconnus avec l’image.
Essayez avec des fichiers fictifs
Les fichiers de démonstration contiennent des données fictives. Gardez les originaux et examinez vos propres copies exportées. Les téléchargements avancés utilisent les quotas actuels et offres Pro.
Pour poursuivre votre travail :
Questions fréquentes
L’OCR traduit-il mon PDF ?
Non. Il reconnaît les caractères dans les images. Pour traduire le contenu, utilisez l’outil de traduction après avoir vérifié le texte reconnu.
Comment obtenir un PDF dans lequel on peut rechercher des mots ?
Choisissez la sortie PDF après reconnaissance. Ouvrez le fichier dans un lecteur et essayez de rechercher un mot présent sur la page.
Les chiffres sont-ils toujours reconnus sans erreur ?
Non. Comparez les montants, dates et références avec l’image originale. Un aperçu qui semble plausible ne remplace pas cette vérification.
Mes documents sont-ils envoyés à un serveur ?
Non. Le PDF est traité dans votre navigateur. Des logiciels, polices ou modèles de reconnaissance peuvent être téléchargés si nécessaire. Les données de compte, de paiement et les données techniques sont traitées séparément selon la politique de confidentialité.
Cela fonctionne-t-il sur téléphone ?
Utilisez un navigateur moderne compatible sur téléphone, tablette ou ordinateur. Les documents volumineux ou complexes dépendent de la mémoire de votre appareil et peuvent prendre plus de temps.
Est-ce gratuit ?
Les téléchargements avancés utilisent le quota quotidien de fichiers indiqué dans l’outil. Les quotas des invités et des comptes gratuits peuvent différer. Pro supprime le quota quotidien de fichiers et se renouvelle chaque mois ou chaque année. Quotas actuels et offres Pro.
Pourquoi les mots du scan de démonstration ne peuvent-ils pas être copiés avant l’OCR ?
Le fichier contient une image de page sans couche de texte. L’OCR peut essayer de reconnaître ses mots et de créer la sortie compatible choisie. Relisez le résultat en le comparant à l’image, car la précision des caractères n’est pas garantie.