

 Español
 English
 Français
 Deutsch
 Italiano
 Português
 日本語
 Русский
 한국어
 简体中文
 繁體中文
 العربية
 Български
 Català
 Nederlands
 Ελληνικά
 हिन्दी
 Bahasa Indonesia
 Bahasa Melayu
 Polski
 Svenska
 ไทย
 Türkçe
 Українська
 Tiếng Việt
 Kiswahili
Todas las herramientas › Convertir
Reconocer texto de un PDF escaneado con OCR
El OCR reconoce caracteres que están dentro de una imagen. Permite buscar o copiar palabras de un escaneo y continuar con ellas en otros formatos. El reconocimiento funciona en el navegador; sus descargas usan el acceso avanzado disponible.
Las descargas avanzadas utilizan el cupo diario de archivos que muestra la herramienta. Los cupos de invitados y cuentas gratuitas pueden ser distintos. Pro elimina el límite diario de archivos y se renueva mensual o anualmente. Límites actuales y planes Pro.
Reconocer texto del PDFDocumentos procesados en tu dispositivo · funciona en el navegadorCómo aplicar OCR a un PDF
- Abre el PDF escaneado y selecciona el idioma de su contenido, que puede ser distinto al idioma de la interfaz.
- Inicia el reconocimiento y mantén abierta la página hasta que termine. Los modelos de idioma pueden descargarse cuando se necesitan.
- Revisa las palabras de la vista previa, especialmente nombres, fechas, importes y referencias.
- Elige PDF con texto reconocible, DOCX o TXT y descarga con el acceso avanzado disponible. Abre el archivo para comprobarlo.
Reconocer también texto en imágenes
Si el PDF combina títulos seleccionables y texto en imágenes, activa «Reconocer también texto en imágenes» antes de iniciar OCR. Después guarda un PDF con búsqueda o continúa a Word. Se conserva el texto seleccionable y se omiten palabras OCR superpuestas para evitar duplicados. Revisa el resultado antes de usarlo.
PDF con búsqueda, Word o texto plano
El PDF reconocible conserva la apariencia del escaneo y añade una capa de texto. Un lector compatible puede buscar y seleccionar las palabras reconocidas. No transforma la página en párrafos de Word.
DOCX sirve para continuar en un procesador de textos y puede necesitar correcciones de diseño. TXT guarda el texto sin la composición de las páginas. Elige el formato según lo que quieras hacer después.
Elegir el idioma y mejorar la imagen de origen
Selecciona el idioma del documento para orientar el reconocimiento. Cambiar el idioma de la interfaz no traduce el contenido del PDF. El OCR reconoce palabras; la traducción es una operación diferente.
Un escaneo nítido y recto suele funcionar mejor que una foto borrosa o un texto diminuto. Comprueba confusiones como O y 0 o I y 1. La escritura a mano y las páginas complejas pueden dar resultados incompletos.
Procesar y comprobar en tu dispositivo
El archivo se procesa localmente en el navegador. Pueden descargarse programas y modelos de reconocimiento; eso no significa que se suba el documento para reconocerlo.
Los PDF extensos consumen memoria y tardan más. Puedes extraer primero un grupo de páginas con Dividir PDF y aplicar OCR a esa copia. Las descargas de OCR utilizan el cupo diario de archivos disponible o Pro; consulta las condiciones actuales.
Prueba con documentos de ejemplo
Los ejemplos contienen datos de demostración, sin información real de clientes. Se indica cuando el documento de origen está en inglés. Conserva el original para comparar opciones; un resultado de ejemplo no garantiza el mismo comportamiento en todos los PDF.
Reconocer una página que todavía no tiene texto seleccionable
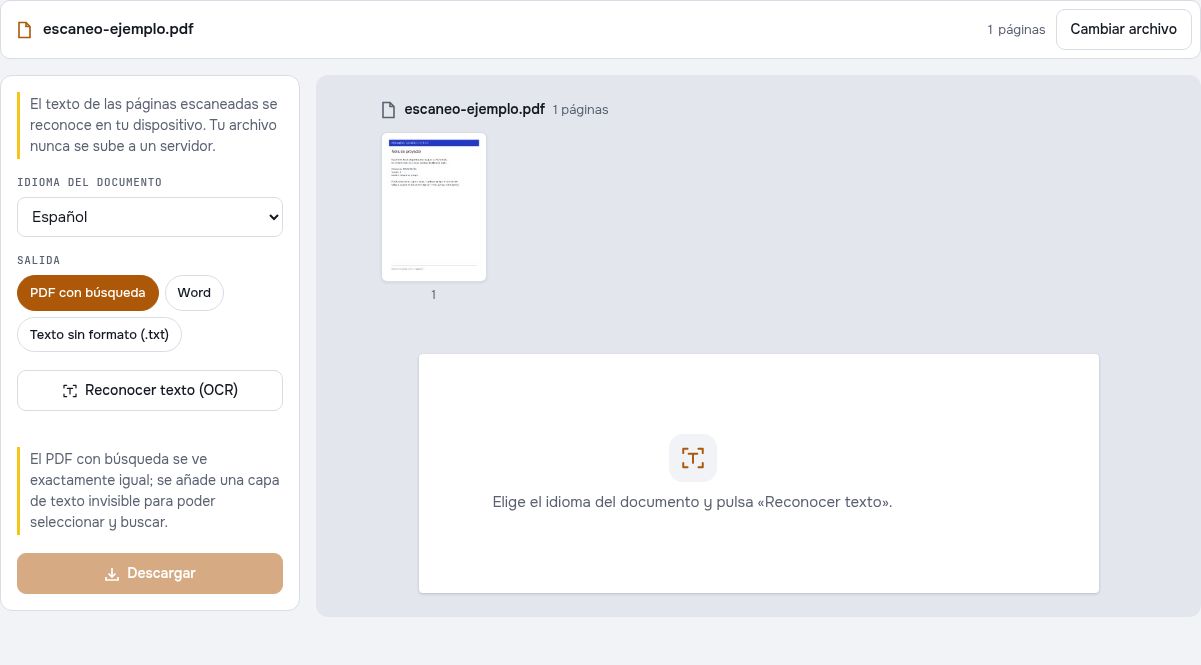
El escaneo de ejemplo contiene una imagen de la nota de proyecto y carece de capa de texto. Prueba a seleccionar sus palabras en un lector antes de aplicar OCR. Después compara el texto reconocido con la imagen y con el PDF de texto original.
Elegir el idioma impreso en el documento
Selecciona español para este escaneo aunque utilices la interfaz en otro idioma. El idioma de los menús no identifica automáticamente el texto de una imagen. Empieza con esta única página para comprobar la disponibilidad de los recursos y la capacidad del dispositivo.
Revisar palabras, acentos y referencias
Comprueba la referencia DEMO-ES-001, la etiqueta Versión: A y el nombre Usuario de ejemplo. Presta atención a las letras acentuadas y a los caracteres parecidos. Poder encontrar una palabra no demuestra que el reconocimiento sea correcto en toda la página ni que el orden de lectura se haya conservado.
Comprueba el resultado
- Verifica que el escaneo inicial no permita seleccionar palabras.
- Elige español como idioma de reconocimiento.
- Compara nombres y códigos reconocidos con la imagen de origen.
Prueba con archivos ficticios
Los archivos de práctica contienen datos ficticios. Conserva los originales y revisa tus propias copias exportadas. Las descargas avanzadas utilizan los límites actuales y planes Pro.
Continúa con estas herramientas:
Preguntas frecuentes
¿OCR sirve para traducir un PDF?
No. Reconoce los caracteres de las páginas. Para traducir el texto, continúa con la herramienta de traducción después de revisar el reconocimiento.
¿Cómo obtengo un PDF en el que se pueda buscar?
Selecciona el formato PDF después de reconocer el texto. Abre la descarga y prueba una búsqueda de una palabra que aparezca en la página.
¿OCR reconoce siempre todos los números correctamente?
No. Revisa importes, fechas, referencias y otros datos importantes contra la imagen original, aunque la vista previa parezca correcta.
¿Se suben mis documentos a un servidor?
No. El procesamiento del PDF se realiza en tu navegador. Pueden descargarse programas, fuentes o modelos de reconocimiento. Los datos de cuenta, pago y uso técnico se tratan por separado, según la política de privacidad.
¿Funciona en el móvil?
Utiliza un navegador moderno compatible en tu móvil, tableta u ordenador. Los documentos grandes o complejos dependen de la memoria del dispositivo y pueden tardar más.
¿Es gratis?
Las descargas avanzadas utilizan el cupo diario de archivos que muestra la herramienta. Los cupos de invitados y cuentas gratuitas pueden ser distintos. Pro elimina el límite diario de archivos y se renueva mensual o anualmente. Límites actuales y planes Pro.
¿Por qué el escaneo de ejemplo no permite copiar palabras antes del OCR?
Contiene una imagen de página sin una capa de texto. El OCR puede intentar reconocer las palabras y generar el formato compatible que elijas. Compara el resultado con la imagen, porque la precisión de los caracteres no está garantizada.