

 Deutsch
 English
 Español
 Français
 Italiano
 Português
 日本語
 Русский
 한국어
 简体中文
 繁體中文
 العربية
 Български
 Català
 Nederlands
 Ελληνικά
 हिन्दी
 Bahasa Indonesia
 Bahasa Melayu
 Polski
 Svenska
 ไทย
 Türkçe
 Українська
 Tiếng Việt
 Kiswahili
Alle Werkzeuge › Umwandeln
Gescanntes PDF mit OCR durchsuchbar machen
OCR erkennt Zeichen in Seitenbildern, damit du Wörter suchen, kopieren oder weiterverarbeiten kannst. Die Erkennung läuft im Browser auf deinem Gerät. Für die Ausgabe gelten die Bedingungen für erweiterte Downloads.
Erweiterte Downloads nutzen das im Werkzeug angezeigte tägliche Dateikontingent. Die Kontingente für Gäste und kostenlose Konten können sich unterscheiden. Pro hebt das tägliche Dateikontingent auf und verlängert sich monatlich oder jährlich. Aktuelle Kontingente und Pro-Pläne.
PDF-Text erkennenDokumentverarbeitung auf deinem Gerät · direkt im BrowserSo führst du OCR für ein PDF aus
- Öffne das gescannte PDF und wähle die Sprache des Dokuments. Sie muss nicht der Sprache der Oberfläche entsprechen.
- Starte die Erkennung und lasse die Seite geöffnet. Benötigte Sprachmodelle können beim ersten Einsatz heruntergeladen werden.
- Prüfe die Textvorschau, besonders Namen, Datumsangaben, Beträge und Referenznummern.
- Wähle PDF, DOCX oder TXT und nutze den verfügbaren erweiterten Download. Öffne die gespeicherte Datei zur Kontrolle.
Auch Text in Bildern erkennen
Enthält das PDF auswählbare Überschriften und Text in Bildern, aktivieren Sie vor dem OCR-Start „Auch Text in Bildern erkennen“. Speichern Sie danach ein durchsuchbares PDF oder wechseln Sie zu Word. Auswählbarer Text bleibt erhalten; überlappende OCR-Wörter werden zur Vermeidung von Duplikaten ausgelassen. Prüfen Sie das Ergebnis vor der Verwendung.
Durchsuchbare PDF, Word oder reiner Text
Eine durchsuchbare PDF behält das Scanbild und erhält eine zusätzliche Textebene. Ein kompatibler PDF-Reader kann darin erkannte Wörter suchen und auswählen. Die Seite wird dadurch nicht zu einem Word-Dokument.
DOCX eignet sich zur Weiterarbeit im Textprogramm, kann aber Korrekturen an Text und Layout erfordern. TXT enthält den erkannten Text ohne ursprüngliche Seitengestaltung. Wähle die Ausgabe passend zu deiner nächsten Aufgabe.
Dokumentensprache und Scanqualität beachten
Stelle die Sprache des Seiteninhalts ein, um die Erkennung zu unterstützen. Eine andere Oberflächensprache übersetzt das Dokument nicht. Texterkennung und Übersetzung sind getrennte Vorgänge.
Gerade, scharfe Scans funktionieren meist besser als unscharfe Fotos oder sehr kleine Schrift. Prüfe ähnliche Zeichen wie O und 0 oder I und 1. Handschrift und komplexe Seiten können unvollständig erkannt werden.
Lokale Verarbeitung und praktische Grenzen
Das PDF wird im Browser verarbeitet. Software und Erkennungsmodelle können dabei heruntergeladen werden; das ist kein Upload deines Dokuments zur Texterkennung.
Große Dokumente benötigen mehr Arbeitsspeicher und Zeit. Mit PDF teilen kannst du vorher einen kleineren Seitenbereich extrahieren. OCR-Downloads nutzen das verfügbare tägliche Dateikontingent oder Pro.
Mit Beispieldokumenten ausprobieren
Die Beispiele enthalten erfundene Daten, keine echten Kundeninformationen. Englische Ausgangsdokumente sind gekennzeichnet. Behalte das Original zum Vergleich; ein Beispiel garantiert nicht dasselbe Verhalten für jede PDF.
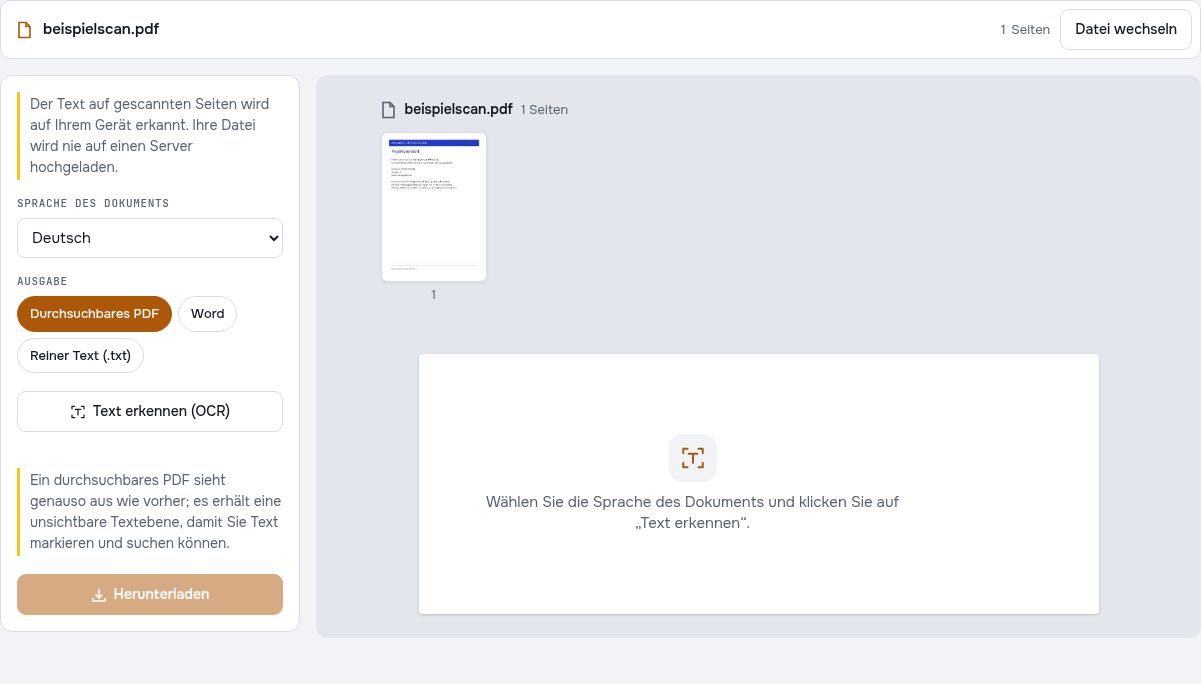
Eine deutsche Beispielseite ohne Textebene mit OCR prüfen
Die bereitgestellte Scan-PDF enthält nur das Bild der ersten Berichtsseite. Ihre Wörter lassen sich zunächst nicht als Text auswählen. Stelle Deutsch als Erkennungssprache ein und wähle ein verfügbares Ausgabeformat. Die Abbildung zeigt die Vorbereitung vor der Texterkennung.
Die Sprache des Inhalts auswählen
Entscheidend ist die gedruckte Sprache, nicht die Sprache der Bedienoberfläche. Prüfe die Ausrichtung und die Lesbarkeit des Bildes vor dem Start. Bei eigenen Dokumenten helfen klare Schrift und gleichmäßige Beleuchtung; abgeschnittene oder unscharfe Zeichen können durch OCR nicht zuverlässig ergänzt werden.
Referenzen und Sonderzeichen gegenlesen
Vergleiche im Ergebnis DEMO-DE-001 sowie Wörter mit Umlauten oder ß mit der Bildvorlage. Wenn du eine durchsuchbare PDF erzeugst, suche nach einem vollständigen Wort und kontrolliere die Position der Auswahl. Für Word oder Text prüfst du zusätzlich die Reihenfolge der erkannten Zeilen.
Das Ergebnis prüfen
- Prüfe, dass die Ausgangsdatei keine auswählbare Textebene hat.
- Wähle Deutsch passend zum gedruckten Inhalt.
- Vergleiche Referenz, Umlaute und Wortsuche mit dem Originalbild.
Mit fiktiven Dateien ausprobieren
Die Beispieldateien enthalten frei erfundene Daten. Behalte die Originale und prüfe deine eigenen exportierten Kopien. Für erweiterte Downloads gelten die aktuellen Kontingente und Pro-Pläne.
Mit diesen Werkzeugen weiterarbeiten:
Häufige Fragen
Übersetzt OCR mein PDF?
Nein. OCR erkennt die Zeichen in den Bildern. Zum Übersetzen dient das Übersetzungswerkzeug, nachdem du den erkannten Text geprüft hast.
Wie erhalte ich ein durchsuchbares PDF?
Wähle nach der Erkennung das PDF-Format. Öffne die Ausgabe in einem PDF-Reader und suche testweise nach einem Wort auf der Seite.
Werden Zahlen immer fehlerfrei erkannt?
Nein. Vergleiche Beträge, Daten und Referenznummern mit dem ursprünglichen Scan. Eine plausible Textvorschau ersetzt diese Prüfung nicht.
Werden meine Dokumente auf einen Server hochgeladen?
Nein. Die PDF-Verarbeitung erfolgt in deinem Browser. Software, Schriftarten oder Erkennungsmodelle können bei Bedarf heruntergeladen werden. Konto-, Zahlungs- und technische Daten werden gemäß der Datenschutzerklärung separat verarbeitet.
Funktioniert das auf dem Smartphone?
Verwende einen unterstützten modernen Browser auf Smartphone, Tablet oder Computer. Große oder komplexe Dokumente benötigen entsprechend viel Arbeitsspeicher und können länger dauern.
Ist das kostenlos?
Erweiterte Downloads nutzen das im Werkzeug angezeigte tägliche Dateikontingent. Die Kontingente für Gäste und kostenlose Konten können sich unterscheiden. Pro hebt das tägliche Dateikontingent auf und verlängert sich monatlich oder jährlich. Aktuelle Kontingente und Pro-Pläne.
Warum gibt es für den OCR-Test eine eigene Scan-PDF?
Der normale Beispielbericht enthält bereits auswählbaren Text. Die Scan-PDF enthält dagegen nur ein Seitenbild und eignet sich deshalb zum Prüfen der Texterkennung. Wähle Deutsch und vergleiche die Ausgabe mit der Vorlage; die Erkennungsqualität hängt vom Dokument ab.