

 Português
 English
 Español
 Français
 Deutsch
 Italiano
 日本語
 Русский
 한국어
 简体中文
 繁體中文
 العربية
 Български
 Català
 Nederlands
 Ελληνικά
 हिन्दी
 Bahasa Indonesia
 Bahasa Melayu
 Polski
 Svenska
 ไทย
 Türkçe
 Українська
 Tiếng Việt
 Kiswahili
Todas as ferramentas › Converter
Reconhecer texto de PDF digitalizado com OCR
O OCR reconhece caracteres nas imagens das páginas para que você possa pesquisar, copiar ou continuar trabalhando com as palavras. O reconhecimento roda no navegador. As saídas usam as condições de download avançado disponíveis.
Os downloads avançados utilizam o limite diário de arquivos indicado na ferramenta. Os limites de visitantes e contas gratuitas podem ser diferentes. Pro remove o limite diário de arquivos e se renova mensal ou anualmente. Limites atuais e planos Pro.
Reconhecer texto do PDFDocumentos processados no seu dispositivo · direto no navegadorComo aplicar OCR a um PDF
- Abra o PDF digitalizado e selecione o idioma do conteúdo. Ele pode ser diferente do idioma da interface.
- Inicie o reconhecimento e mantenha a página aberta. Os modelos de idioma podem ser baixados quando necessários.
- Revise a prévia do texto, especialmente nomes, datas, valores e números de referência.
- Escolha PDF pesquisável, DOCX ou TXT e baixe com o acesso avançado disponível. Abra o arquivo para conferir.
Reconhecer também texto em imagens
Se o PDF combinar títulos selecionáveis e texto em imagens, ative «Reconhecer também texto em imagens» antes de iniciar o OCR. Depois guarde um PDF pesquisável ou continue para Word. O texto selecionável é mantido e as palavras OCR sobrepostas são omitidas para evitar duplicados. Reveja o resultado antes de o utilizar.
PDF pesquisável, Word ou texto simples
Um PDF pesquisável mantém a aparência da digitalização e acrescenta uma camada de texto. Um leitor compatível pode localizar e selecionar as palavras reconhecidas. Isso não transforma a página em um documento Word.
DOCX permite continuar em um editor de texto e pode precisar de correções de conteúdo e layout. TXT guarda o texto sem a composição das páginas. Escolha o formato de acordo com a próxima tarefa.
Idioma do documento e qualidade da digitalização
Selecione o idioma das páginas para orientar o reconhecimento. Trocar o idioma da interface não traduz o PDF. Reconhecer texto e traduzir são operações diferentes.
Uma digitalização nítida e alinhada costuma funcionar melhor que uma foto borrada ou letras muito pequenas. Confira caracteres parecidos, como O e 0 ou I e 1. Manuscritos e páginas complexas podem ter reconhecimento incompleto.
Processamento local e limites práticos
O PDF é processado no navegador. Programas e modelos de reconhecimento podem ser baixados durante o uso; isso não significa que o documento é enviado para um servidor de OCR.
Arquivos extensos usam mais memória e tempo. Você pode extrair antes um grupo menor de páginas com Dividir PDF. Os downloads de OCR usam o limite diário de arquivos disponível ou Pro.
Experimente com documentos de exemplo
Os exemplos contêm dados de demonstração, sem informações reais de clientes. Indicamos quando o documento está em inglês. Guarde o original para comparar opções; um resultado de exemplo não garante o mesmo comportamento em todos os PDF.
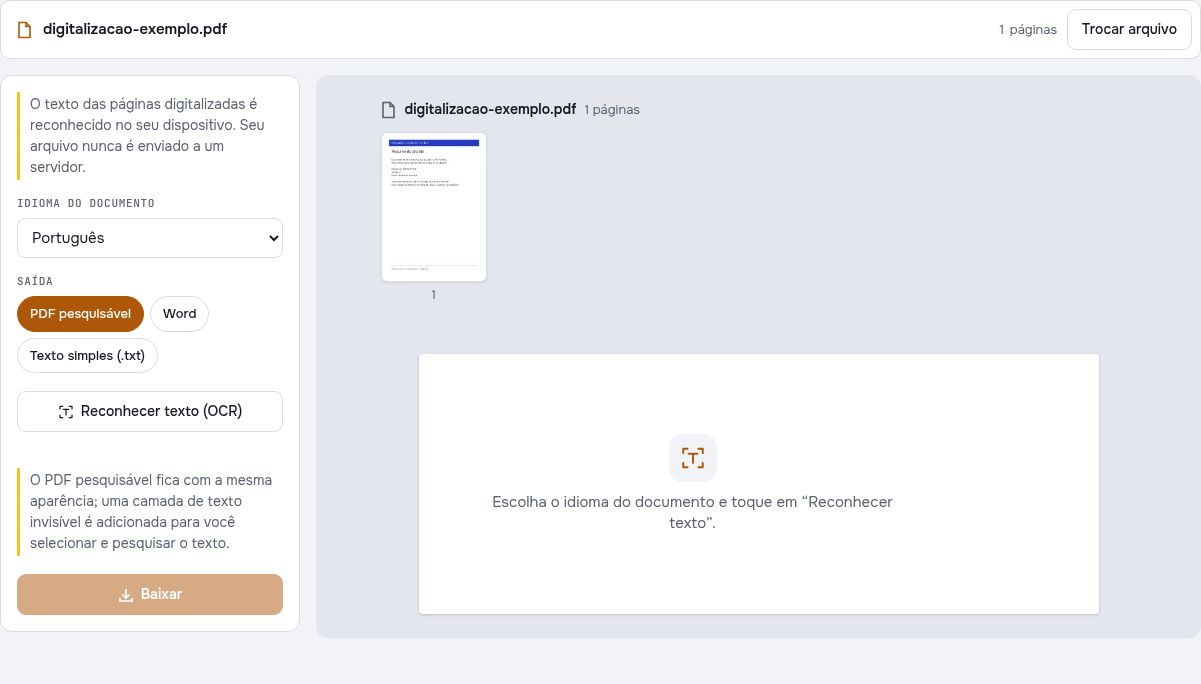
Reconhecer uma página que ainda não tem texto selecionável
A digitalização de exemplo contém uma imagem do resumo do projeto, sem camada de texto. Tente selecionar as palavras em um leitor antes do OCR. Depois, compare o texto reconhecido com a imagem e com o PDF de texto original.
Escolher o idioma impresso na página
Selecione português para este exemplo, mesmo que a interface esteja em outro idioma. O idioma dos menus não identifica automaticamente as palavras de uma imagem. Comece com esta única página para conferir os recursos disponíveis e a capacidade do dispositivo.
Revisar acentos e referências
Confira DEMO-PT-001, Versão: A e Usuário de exemplo. Preste atenção aos caracteres acentuados e às letras parecidas com números. Encontrar uma palavra não confirma que todos os caracteres ou a ordem de leitura da página tenham sido reconhecidos corretamente.
Confira o resultado
- Confirme a ausência de texto selecionável na digitalização inicial.
- Escolha português como idioma de reconhecimento.
- Compare os nomes e códigos reconhecidos com a imagem.
Teste com arquivos fictícios
Os arquivos de demonstração contêm dados fictícios. Guarde os originais e confira suas próprias cópias exportadas. Os downloads avançados utilizam os limites atuais e planos Pro.
Continue com estas ferramentas:
Perguntas frequentes
OCR traduz o PDF?
Não. OCR reconhece os caracteres nas imagens. Para traduzir o conteúdo, use a ferramenta de tradução depois de revisar o texto reconhecido.
Como criar um PDF no qual seja possível pesquisar?
Escolha a saída PDF depois do reconhecimento. Abra o arquivo em um leitor e teste a busca por uma palavra que apareça na página.
Os números são sempre reconhecidos sem erro?
Não. Compare valores, datas e referências com a imagem original. Uma prévia que parece correta não substitui essa conferência.
Meus documentos são enviados para um servidor?
Não. O PDF é processado no seu navegador. Programas, fontes ou modelos de reconhecimento podem ser baixados quando necessário. Dados de conta, pagamento e uso técnico são tratados separadamente, conforme a política de privacidade.
Funciona no celular?
Use um navegador moderno compatível no celular, tablet ou computador. Documentos grandes ou complexos dependem da memória do dispositivo e podem levar mais tempo.
É grátis?
Os downloads avançados utilizam o limite diário de arquivos indicado na ferramenta. Os limites de visitantes e contas gratuitas podem ser diferentes. Pro remove o limite diário de arquivos e se renova mensal ou anualmente. Limites atuais e planos Pro.
Por que não consigo copiar as palavras da digitalização antes do OCR?
O arquivo contém uma imagem de página sem camada de texto. O OCR pode tentar reconhecer as palavras e gerar a saída compatível escolhida. Compare o resultado com a imagem, pois a precisão dos caracteres não é garantida.